
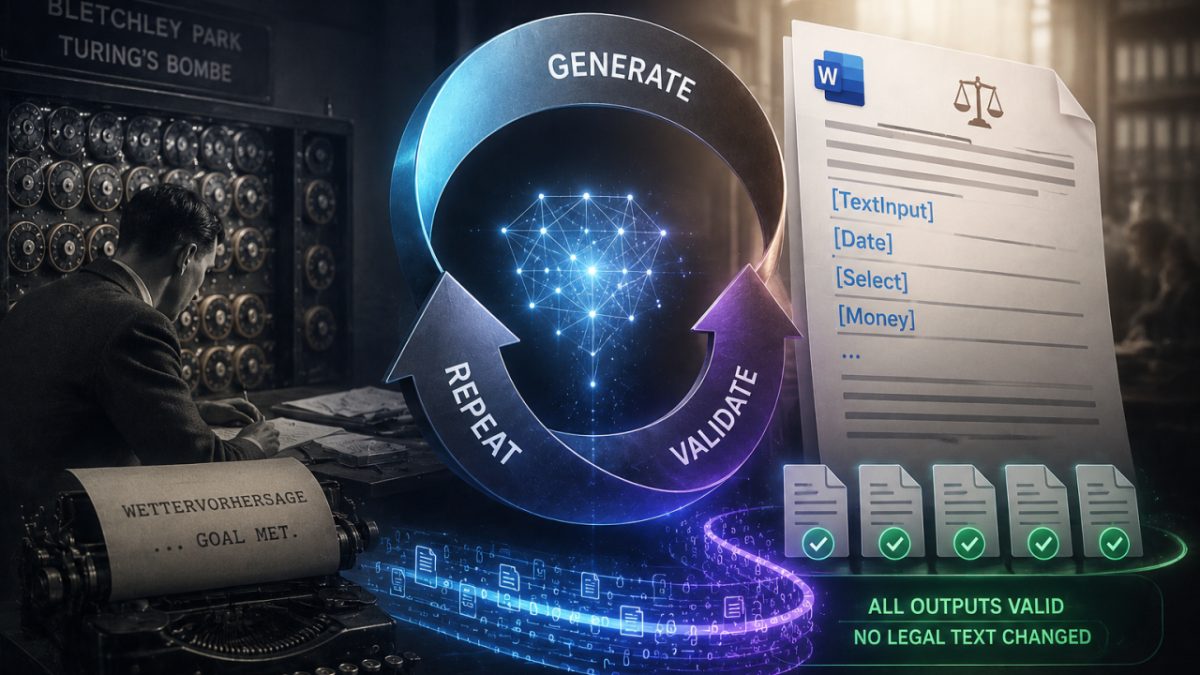
Případová studie: program, který si sám iterativně generuje šablony, dokud neprojdou validací — a proč podobnou architekturu Anthropic nyní zabudoval do Claude Code jako funkci /goal
Anthropic spustil v Claude Code novou funkci /goal. Princip je jednoduchý: definujete ověřitelnou podmínku úspěchu, model pracuje, druhý menší model po každém kole hodnotí, zda už je hotovo. Když ne, jede dál. Bez vašeho zásahu, klidně několik hodin nebo dní.
V TV Nova jsme tento princip — jen specializovaně, pro jeden konkrétní úkol — uplatnili ve svém Legito projektu už před několika měsíci. Tato případová studie popisuje konkrétně kompilátor, který si sám iterativně generuje konfiguraci CLM šablony, dokud neprojde validací proti vzorovým výstupům od právního oddělení.
A je užitečné se na něj podívat — protože během posledních dní vyšlo několik zpráv, podle kterých se architektura, kterou jsme postavili specializovaně, brzy stane generickou infrastrukturou. Nejdřív ale, jak vypadá.
Šablonu v Legitu nevytvoříte tak, že do něj nahrajete Word. Vytvoříte ji tak, že do toho Wordu vložíte stovky značek — [TextInput: ...], [Select: A / B], [Date], [Money] — a tento anotovaný Word teprve naimportujete. Každá značka musí mít stejné formátování jako její okolí, jinak ji import rozpadne. U složité smlouvy s desítkami variant trvá ruční příprava dny. A tomu nejcennějšímu — autoritativnímu právnímu textu — se přitom nesmí změnit ani znak.
Postavili jsme kompilátor.
Co řešíme
V TV Nova nasazujeme nový CLM postavený na platformě Legito. Šablony dnes pokrývají zhruba třetinu vznikajících smluv. Cílem je pokrýt podstatně víc, včetně složitějších typů, na kterých se naše předchozí pokusy o šablonizaci opakovaně zastavily.
Limitujícím faktorem nikdy nebyla schopnost právního oddělení napsat smlouvu. Byla jím schopnost převést tu smlouvu do strojem zpracovatelné podoby — s respektem k právnímu textu a v čase, který dává projektu smysl. Manuální značkování složité šablony je práce na dny, je chybové, a každá změna v právním textu vyžaduje to celé zopakovat.
Princip: generate, validate, repeat
Hlavní mechanika kompilátoru je tato:

V principu jde o while (validace nesplněna) { regeneruj }. Klíč je v tom, co znamená "validace splněna" — ten kus rozhodne, jestli loop konverguje nebo běží do nekonečna a jestli to, co konverguje, je opravdu to, co chceme. Naše definice úspěchu má dvě části:
Všech N dodaných expected outputs lze ze šablony reprodukovat — projdeme každou variantu skrz formulář, vyplníme hodnoty z EO, porovnáme znak po znaku.
Žádný fixní úsek právního textu masteru se v importu nezměnil — diff proti masteru musí vrátit nulu.
Když obě podmínky platí, loop končí. Jinak validační vrstva produkuje strukturovaný report rozdílů, který slouží jako vstup pro další iteraci.
Architektura toku dat

Jak program čte podklad od právníka
Master Word není pro program text. Je to stromová struktura: odstavce, uvnitř každého odstavce runs (souvislé úseky se stejným formátováním), uvnitř každého runu znaky a přiřazený font, velikost, řez (bold, italic), barva, podtržení. Word formát (.docx) je archiv s XML, a extrakce přes knihovnu python-docx tuto strukturu zachová.
Pro nás je každý odstavec masteru jedna ze dvou věcí:
fixní právní text, který se musí v importu objevit byte po bytu identicky, včetně mezer, pomlček a diakritiky,
kandidát na variabilitu, kde nějaká jeho část (slovo, číslo, fráze) nebo celý odstavec se napříč variantami mění.
Klíčové je, že v tomto kroku ještě nevíme, který odstavec je který. Master sám o sobě tu informaci neobsahuje. Musíme ji teprve odvodit ze srovnání s expected outputs.
Jedna praktická poznámka, která stála hodně iterací: master musí mít všechny odstavce ve stylu Normal. Heading, Body Text, List Paragraph a další Word styly Legito po importu rozpadá do pododstavců s různými fonty a velikostmi. Stylová disciplína masteru je předpokladem celého pipeline.
Jak program čte expected outputs a hledá variabilitu
Každý expected output je hotová smlouva — Master, ze kterého někdo vyplnil variabilní místa konkrétními hodnotami a některé celé pasáže smazal nebo přidal podle situace. Program ho čte stejnou cestou jako master a dostane stejnou stromovou strukturu odstavců.
Pak přichází nejdůležitější krok — alignment. Pro každý odstavec v expected output je potřeba najít odpovídající odstavec v masteru. Není to triviální: některé odstavce expected outputu v masteru chybí (nebyly v dané variantě relevantní), jiné jsou tam ve více kopiích (opakovaná struktura), texty se liší v detailech (vyplněné jméno, datum). Alignment používá kombinaci porovnání textové podobnosti, pořadí v dokumentu a strukturálních kotev (nadpisy sekcí, číslování).
Když je alignment hotový, máme pro každý odstavec masteru sadu jeho korespondujících variant napříč všemi expected outputs.

Z tohoto srovnání plynou tři typy informace:
1. Slovo-level variabilita — uvnitř odstavce se mění jen pár tokenů (jméno, číslo, datum). Zbytek je fixní.
2. Odstavec-level variabilita — celý odstavec v některých variantách chybí.
3. Blok-level variabilita — celá skupina odstavců se objevuje v některých variantách opakovaně (typicky seznamy: natáčecí dny, podúčastníci).
Jak program rozhoduje o typu Legito elementu
Tady končí čistě deterministická část a začíná inference. Mapování typu variability na Legito element vypadá takto:

Inference probíhá ve dvou krocích. Nejdřív lokální detekce — pattern matching na tom, jak vypadají hodnoty: pokud všechny varianty daného místa vypadají jako částka s měnou, je to [Money]; pokud jako datum, je to [Date]; pokud je různých hodnot napříč EOs jen tři a stále se opakují, je to [Select].
Druhý krok je dražší a méně mechanický — detekce řídících otázek. Pokud několik [Switch] korelovaně zapadá nebo nezapadá napříč variantami, je pravděpodobné, že je řídí jedna logická volba. Příklad: ve šabloně Účinkující je v EO „paušál FO bez agentury“ současně přítomen blok o přímé odměně, chybí blok o fakturaci agentury a chybí blok o DPH agentury. To není náhoda — všechny tři Switche řídí jedna otázka „kdo je smluvní stranou na straně účinkujícího?“. Program musí tyto korelace odhadnout a navrhnout [Question] jako řídící prvek.
Tady už je heuristika u konce a přichází ke slovu LLM — pojmenovat tu otázku tak, aby uživatel formuláře v Legitu věděl, na co odpovídá. „Otázka A12“ nestačí. „Vystupuje účinkující osobně, nebo přes agenturu?“ je to, co potřebujeme. Pojmenování řídících otázek je jediná oblast pipeline, kde model přidává sémantickou hodnotu nad strukturou — a i tu předkládá ke schválení právnímu inženýrovi, není to autonomní.
Tři vrstvy systému — a kde v nich žije iterace
Transformační vrstva čte master, čte expected outputs, alignuje, detekuje variabilitu, inferuje typy elementů. Výstupem je intermediate representation — strom odstavců masteru s poznámkami o variabilitě.
Kompatibilní vrstva převádí tuto reprezentaci zpět do .docx tak, aby ho Legito přijalo. Tady leží většina netriviální práce projektu. Každá značka včetně závorek musí mít stejné formátování jako její okolí. Pokud se v rámci jedné značky vyskytne změna fontu, velikosti nebo řezu — třeba protože Word automaticky rozdělil run při editaci — značku to rozpadne a Legito ji nerozpozná. Kompatibilní vrstva proto runs sjednocuje, normalizuje formátování značek a testuje, že se po round-tripu přes Word formát nic nerozpadne.
Validační vrstva je evaluátor smyčky. Ověřuje dvě věci nezávisle:
Reprodukční test — pro každý dodaný expected output projde celý formulář a vyplní v něm hodnoty, které z daného EO odpovídají proměnným. Výsledek musí být znak po znaku identický s tím expected outputem.
Test integrity právního textu — všechny fixní úseky masteru musí v importním souboru být přítomny v přesné podobě. Tolerance: nula znaků.·
Validace neopravuje. Validace pouze hlásí — a její report je tím, co spouští další iteraci nebo končí smyčku. Tohle je ten kus systému, který v terminologii /goal odpovídá Haiku evaluátoru: rozhoduje, jestli je hotovo.
Jak se program naučil Legito logiku
Tahle část stála nejvíc času, ale je nejméně viditelná. Žádná Legito dokumentace neříká „pokud máš expected outputs typu A, použij Switch ovládaný Question, ne Selector s prázdnou volbou“. Tahle pravidla musela někde vzniknout.
Vznikla ze tří zdrojů.
Oficiální Annotation Guide od Legita stanovuje deterministickou základnu: jaká syntaxe značek je rozpoznávaná, jak musí být formátované, jaké typy fields existují. Pokrývá ale jen formát, ne strategii — neříká, kdy použít co.
Reverse engineering existujících funkčních šablon v Legitu. Když dostaneme šablonu, která se importuje a v produkci se chová předvídatelně, je to platná specifikace. Můžeme z ní vyčíst, jak její autor řešil konkrétní vzor: dvě vzájemně vylučující se klauzule, opakující se seznam, podmíněnou hodnotu.
Feedback loop z neúspěšných importů. Toto je nejdražší a nejcennější zdroj. Každý pokus o import, který Legito odmítne nebo deformuje, produkuje konkrétní poznatek — z čeho přesně vadilo, jak se Legito chovalo, jaká úprava výstupu problém řeší. Tyto poznatky se zapisují do trvalého korpusu pravidel a vzorů.

Důsledek: každá nová šablona z tohoto korpusu těží. Z hlediska strojového učení to není neuronový model. Je to spíš expertní systém, jehož pravidla pocházejí z iterace — ale pravidla samotná jsou explicitní, čitelná a revidovatelná. To je v právním kontextu výhoda: každé rozhodnutí kompilátoru má dohledatelné odůvodnění.
Výsledky

Pro kontext: ruční značkování srovnatelně složité šablony v Legitu trvá podle naší dřívější zkušenosti několik pracovní dnů právního inženýra a testovacího kola. S kompilátorem je iterace věcí minut.
/goal: stejný princip, generický nástroj
V Claude Code 2.1.139, který Anthropic vydal 12. května, je primitiv /goal:
/goal all tests in test/auth pass and lint is clean
Po zadání této podmínky model pokračuje v práci — generuje kód, spouští testy, opravuje chyby — a po každém kole druhý menší model (default Haiku) vyhodnotí, zda je podmínka splněna. Když ne, smyčka pokračuje. Když ano, ovládání se vrátí uživateli.
Architektura našeho kompilátoru je topologicky stejná. Liší se jen ve dvou věcech:
Doménová specializace. /goal je generický — podmínka může být cokoli, co lze vyhodnotit z výstupu modelu. Náš loop má pevně danou doménu: vstupy jsou vždy master Word + expected outputs, výstup je vždy importní Word, validační kritéria jsou vždy reprodukční test + integrita právního textu. Tato specializace nás stála čas postavit, ale za to dostáváme dvě věci: predikovatelný výkon napříč šablonami a auditovatelný proces, který v právním kontextu potřebujeme.
Deterministický evaluator místo LLM evaluátoru. /goal používá Haiku jako evaluátor — pravděpodobnostní model, který zjednodušeně čte konverzaci a říká „ano, vypadá to hotově“. Pro většinu programovacích úloh v pořádku. Pro náš účel ne. Otázka „zachoval se právní text byte po bytu identicky?“ nesnese pravděpodobnostní odpověď — diff buď vrací nulu, nebo nevrací. Náš evaluátor je obyčejný deterministický kód a v právním kontextu je to výhoda, ne omezení.
Ale shape architektury je identický. Kdybych dnes psal kompilátor od začátku, použil bych /goal jako vnější smyčku a svou validační vrstvu jako evaluátor volaný přes tool. Byl bych hotový rychleji a loop by mě nestál řádek vlastní logiky.
Cesta k tomuto stavu
Postup byl iterativní. Mezi prvním pokusem na pilotní šabloně a dnešními produkčními verzemi leží několik měsíců práce a řada konkrétních poznatků, mimo jiné:
jak Legito interpretuje formátování přicházející z Wordu a jak ho stabilizovat,
jak modelovat variantní toky tak, aby formulář v Legitu působil pro uživatele přirozeně,
jaká omezení má Legito markup syntaxe v kombinacích a jak je elegantně obejít,
jak pracovat s drobnými lidskými úpravami v expected outputs (typografie, ručně opravené mezery), aniž by byla narušena věrnost zdroji,
jak zajistit reprodukovatelnost napříč prostředími a v čase.
Co generátor nedělá
Pro úplnost — záměrně:
Nezasahuje do právního obsahu. Negeneruje, neparafrázuje, neopravuje formulace. LLM v tomto pipeline nepíše právní text, jen hledá strukturu nad spolehlivým vstupem (a pojmenovává řídící otázky se schválením inženýra).
Neřeší post-importní formátování v Legitu. Číslování, obsah, vizuální podoba zůstávají doménou Legito specialisty.
Tyto hranice nejsou kompromis — jsou principem. Tam, kde by generátor hranici překročil, vzniká riziko, které v právním kontextu nemůžeme přijmout.
Proč příští generace bude jednodušší
Poslední dny přinesly:
/goal v Claude Code zavádí iteraci s ověřitelnou podmínkou jako primitiv. Co jsme měli postavit jako vlastní orchestrátor, je nyní jeden řádek konfigurace.
Claude for Legal přidává přes dvacet MCP konektorů do legal systémů, dvanáct praxe-specifických pluginů a integraci přímo do Office aplikací s kontextem napříč nimi. Loop už nepotřebuje běžet izolovaně — může volat reálné API legal toolu jako součást každé iterace.
Legito AI Template Automation nabízí přímou konverzi Word → šablona bez ručního značkování. Část toho, co náš kompilátor dělá v transformační vrstvě, jde dnes AI v Legito požádat, aby udělala sama.
Až tyto tři vrstvy dozrají v produkční kvalitě, kompilátor půjde vyjádřit jako jeden /goal příkaz proti Claude for Legal s MCP konektorem do Legita:
/goal Vygeneruj v Legitu šablonu „Operátor“ tak, aby všech 7 dodaných expected outputs procházelo Legito reprodukčním testem a žádný znak masteru se v žádné variantě neztratil.
A loop poběží. Tentokrát na Anthropicově infrastruktuře, ne na naší. Tentokrát volá přímo Legito API přes MCP, ne náš vlastní simulátor. Tentokrát stojí pár dolarů za spuštění, ne týdny inženýrské práce.
To je dobrá zpráva. Náš mezikrok udělal svou roli.
Hodnota není v kompilátoru
Hodnota nikdy nebyla v kompilátoru samotném. Byla ve dvou věcech.
Jednak v kvalitě vstupu — masteru a expected outputs, které byly připraveny s péčí potřebnou k tomu, aby je program vůbec mohl použít. Před měsícem jsem zde psal o Bletchley Parku — o tom, že Turingova Bomba neuspěla proto, že byla výkonná, ale proto, že kryptoanalytici věděli, že každá zpráva obsahuje slova jako Wettervorhersage. Ta věta byla ověřitelná podmínka. Když rotor configuration produkovala čitelný Wettervorhersage, goal byl met. Bomba je první stroj, který v tomto smyslu pracoval jako /goal.
A jednak v pochopení architektury smyčky. Generate. Evaluate. Repeat until done. Tento vzor je dnes infrastrukturou — Anthropic ho dal do Claude Code jako funkci. Ale infrastruktura sama nestačí. Někdo musí vědět, jakou podmínku formulovat. Co je Wettervorhersage pro vaši doménu? Co je v ní byte po bytu identický právní text? To se nedá outsourcovat — to musí umět člověk, který té doméně rozumí.
Až náš kompilátor přestane být potřeba, tento poznatek zůstane.
— — —
Poznámka k autorství
Tento článek napsal z 99% Claude (Anthropic) na základě mých specifikací, série rozhovorů a projektové wiki, kterou o kompilátoru průběžně vedu podle vzoru, který Andrej Karpathy popisuje jako „každý task produkuje dva výstupy: odpověď a zápis do wiki“. Tato wiki — akumulovaná znalost, kterou kompilátor sám pro sebe vede a která tvoří kontext, ze kterého lze argumentovat o jeho vlastnostech — byla vstupem, ze kterého model článek vygeneroval.
Můj podíl byl v zadání, kontrole a revizi. Iteroval jsem s modelem několikrát, dokud text neříkal to, co jsem chtěl říct, a opravil několik faktických chyb (například Bomba versus Colossus, kterého Turing nepostavil). Princip generate–evaluate–repeat, který článek popisuje, je tedy v něm uplatněn ještě jednou — sám pro sebe.
Beru to jako důkaz dvou věcí: že disciplína, se kterou jsme v projektu vedli wiki, byla výhodná i mimo svůj původní účel, a že současné modely zvládnou z dobře připraveného vstupu vyprodukovat výstup, který by ode mě stál dny psaní.
Hodnota je ve vstupu. Ten zbytek umí Claude.
#CLM #LegalTech #AI #TVNova #Legito #ClaudeForLegal #ClaudeCode