
Před rokem jsem testoval, jestli POHODU nahradí Business Central.
Dnes mě zajímá opačná otázka: co když ji není potřeba nahrazovat, ale doplnit?
Roky jsem používal E1 s moduly Doprava a PHmobile a mám respekt k tomu, co partnerská síť kolem POHODY vybudovala. Nemyslím si, že to LLM smete – čtečky, terminály, výroba, EDI, mzdy i legislativa zůstanou.
POHODA je hluboce konfigurovatelná. Je v ní vidět třicet let vývoje podle požadavků z praxe a ta hloubka je síla i bariéra: nastavit jde skoro všechno, ale musíte vědět kde, v jakém pořadí a co to udělá jinde. Tuhle znalost drží hotline, konzultanti a partneři – a její ekonomika se s LLM mění.
Několik dní jsem s Claude Code testoval POHODU, XML i mServer. Ne abych postavil další konektor – a záměrně ani MCP server: dát modelu univerzální nástroj a nechat ho sahat do účetnictví je u ERP moc tlustá a důvěřivá vrstva. Zkusil jsem opak: co nejtenčí klient, co nejvíc deterministického kódu, co nejmíň pravomocí pro model.
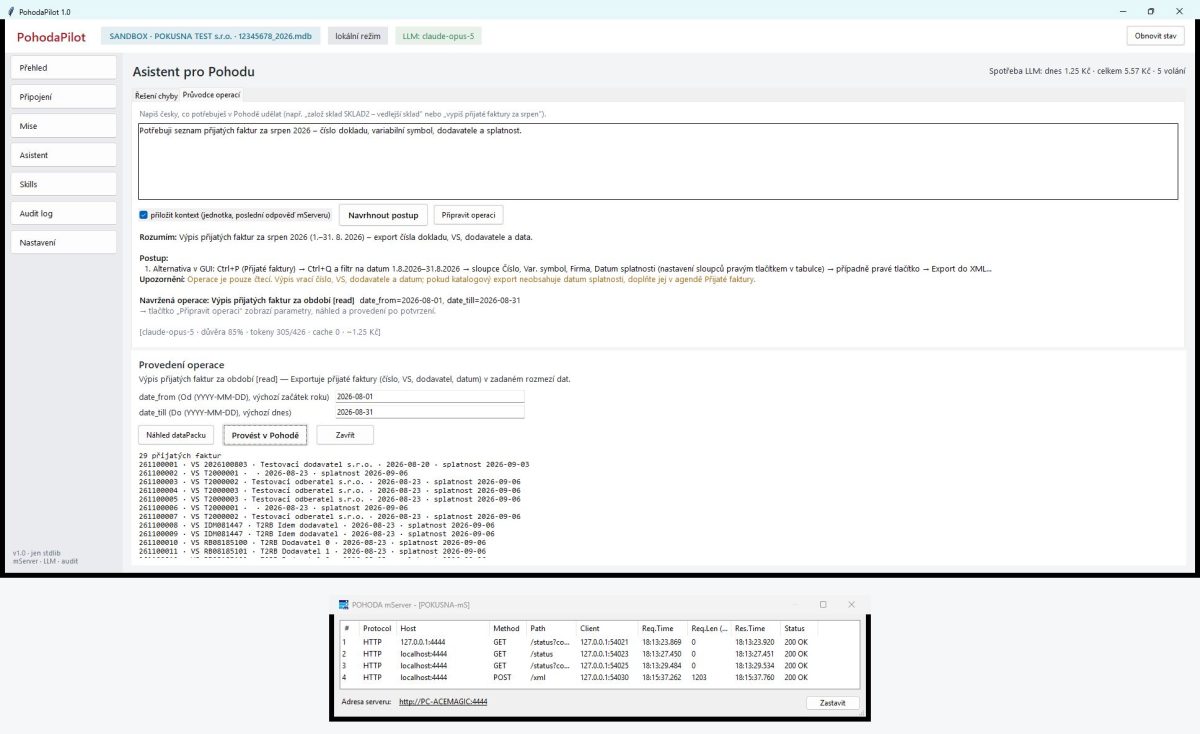
Prototyp je přenosná aplikace, jen standardní knihovna Pythonu, bez instalace a registrace. Uživatel píše přirozeným jazykem, model z uzavřeného katalogu vybere operaci a parametry, kód sestaví XML, odešle je přes mServer a ověří odpověď. Mluví s POHODOU přes HTTP, takže nemusí běžet na stejném počítači – zajímalo mě, kolik se tím dá přidat na síťovosti běžné instalace.
Kde XML nestačí – nastavení, uzávěrky, opravy dokladů – nastoupí RPA přes Win32 API: podle identifikátorů prvků a klávesových zkratek, ne souřadnic. A tady je paradox: to, že je POHODA desktopová, se bere jako zátěž, ale pro deterministické RPA je to výhoda. Pevné zkratky, stabilní prvky, nic se nepřekresluje.
Zajímavější problém je jinde: odkud model ví, jak se POHODA chová? Není to dokumentace. Je to znalost typu „responsePackItem hlásí ok, chyba je až uvnitř" nebo „hláška mluví o členění, ale chybí sklad". Představuju si knihovnu malých strukturovaných skills – a hlavně aparát kolem nich. U wiki funguje desítky let: autor, verze, historie, revize, revert. Tady může být ještě přísnější, protože skill jde otestovat. Každý nese rozsah platnosti (verze a edice POHODY), testovací matici, výsledek zkoušky na pokusné jednotce i podpis. Revize není jen kvalita, ale bezpečnost. Skill je součást instrukcí, podle kterých se model chová – spíš kód než text. Kdyby do báze mohl kdokoli vložit libovolnou „znalost", útočník by nemusel napadat aplikaci; stačilo by mu ji podstrčit.
A je tu spotřeba tokenů: do kontextu nejde dokumentace, ale pár ověřených vět. Znalostní část promptu je navíc stabilní, takže se cachuje: první dotaz vyjde na koruny, další na desetníky.
Takže ne „AI připojená k POHODĚ", ale vrstva nad ní: POHODA jako databáze, účetní a legislativní základ, tenká deterministická vrstva operací, sdílená ověřená znalost + LLM přes API.
A pokud sdílení znalostí funguje u wiki, mohlo by fungovat i u POHODY.
Používali byste takovou znalostní bázi? A nechali byste svá řešení konkrétních problémů převést do ověřených skills?